Se usi un terminale Linux in modo assiduo conoscerai bene i due comandi storici find e grep.
Il primo permette di cercare file e directory, mentre il secondo serve a trovare parole o stringhe di testo all’interno dei file.
Questi due comandi storici sono strumenti potenti, affidabili e presenti praticamente su ogni sistema Unix-like. Tuttavia, ai nostri giorni esistono alternative moderne che possono sostituirli, rendendo molte operazioni quotidiane più semplici e veloci.
Almeno nel mio terminale hanno trovato spazio fd (fd-find) e ripgrep (rg), due piccoli programmi scritti in Rust che offrono grande velocità e praticità.
fd: cercare file senza complicazioni
Se con find, per cercare tutti i file che contengono la parola “config” nel nome, si scrive:
find . -iname '*config*'Con fd, invece, basta:
fd configfd cerca automaticamente nelle sottocartelle e mostra i risultati in modo chiaro, utilizzando anche i colori per distinguere file e directory.
Sì, la ricerca è case-insensitive di default.
Un altro vantaggio è la velocità: grazie alla ricerca parallela, fd può risultare particolarmente rapido quando deve esplorare directory con molti file.
Esempi pratici
Cerchiamo includendo filtro sull’estensione, per esempio tutti i file PDF:
fd -e pdfCerchiamo una cartella chiamata “backup”:
fd -t d backupCerchiamo tutti i file Python che contegono la stringa main:
fd -e py mainUna caratteristica interessante (e da ricordare, per non impazzire 🙂 ) è che fd ignora normalmente i file nascosti e quelli esclusi tramite .gitignore.
Questo comportamento permette di evitare molti risultati inutili, soprattutto quando si lavora su progetti software e repo avviati e maturi.
Naturalmente, se necessario, possiamo modificare questo comportamento con le opzioni appropriate.
Per esempio, se voglio fare una ricerca e includere i file nascosti:
fd -H configripgrep (rg): cercare testo alla velocità della luce
Se fd è una moderna alternativa a find, ripgrep, utilizzabile attraverso il comando rg, rappresenta un’eccellente sotituto moderno a grep.
Immaginiamo di voler cercare la parola “errore” all’interno di tutti i file di una directory e delle sue sottocartelle.
Con grep possiamo utilizzare:
grep -rn "errore" .Con ripgrep è tutto più veloce; basta scrivere:
rg "errore"ripgrep effettua automaticamente una ricerca ricorsiva, mostrando i file che contengono la parola cercata e i relativi numeri di riga.
Inoltre, evidenzia le corrispondenze con i colori, rendendo i risultati più leggibili.
Esempi pratici
Cerchiamo la parola “password” nei file della directory corrente:
rg "password"Cerchiamo la parola “TODO” soltanto nei file Python:
rg "TODO" -g "*.py"Per ricerche case-insensitive:
rg -i "errore"Cerchiamo una parola mostrando anche tre righe prima e dopo ogni risultato:
rg -C 3 "errore"Possiamo anche visualizzare soltanto i nomi dei file che contengono una determinata parola:
rg -l "configurazione"Anche ripgrep, per impostazione predefinita, ignora i file nascosti, i file binari e quelli esclusi da .gitignore.
Per cercare anche nei file nascosti possiamo utilizzare:
rg --hidden "errore"Velocità!
fd utilizza tecniche di esplorazione parallela delle directory, mentre ripgrep impiega un motore di ricerca ottimizzato per individuare rapidamente le corrispondenze nei file.
Entrambi, inoltre, evitano per impostazione predefinita di esaminare molti file che normalmente non interessano all’utente.
Il risultato è che, in numerose situazioni, possono essere sensibilmente più veloci dei comandi tradizionali.
Naturalmente, le prestazioni dipendono dal tipo di ricerca, dal numero di file e dal sistema utilizzato.
fd su sistemi Debian based
Ubuntu, Debian e derivate
sudo apt install fd-find ripgrepSu Debian e Ubuntu il comando fd viene normalmente installato con il nome fdfind.
Quindi gli esempi precedenti possono essere eseguiti sostituendo fd con fdfind.
Se vogliamo utilizzare il nome più breve, possiamo aggiungere un alias al nostro file ~/.bashrc:
alias fd='fdfind'È ora di abbandonare find e grep?
Assolutamente no.
I comandi tradizionali find e grep rimangono fondamentali nell’ecosistema Linux.
Sono disponibili praticamente ovunque, sono estremamente versatili e continuano a essere la scelta ideale per molti script di sistema, soprattutto quando è importante garantire la massima compatibilità.
Inoltre, find offre funzionalità avanzate che fd non cerca di sostituire completamente.
fd e ripgrep non nascono per eliminare i vecchi comandi, ma per rendere più comode le operazioni che svolgiamo ogni giorno.
Un pensiero ai due monumenti
Prima di chiudere questa nota sul mio blog, però, volevo rendere il dovuto omaggio a find e grep oltre che ai rispettivi creatori di questi intramontabili strumenti. Perché se è vero che nella vita di tutti i giorni nel terminale alcune alternative possono velocizzare qualche battuta… stiamo pur sempre parlando di due autentici monumenti della storia di Unix (uomini e comandi 🙂).
Le origini di find e grep risalgono ai leggendari Bell Labs di AT&T, negli Stati Uniti, dove negli anni Settanta prendeva forma Unix.
grep nacque nel 1973 grazie a Ken Thompson, uno dei padri di Unix, su richiesta di Doug McIlroy, che aveva bisogno di cercare parole in un dizionario. Il suo nome deriva dal comando g/re/p dell’editor ed, utilizzato per cercare e stampare le righe corrispondenti a un’espressione regolare (global, regular expression, print).
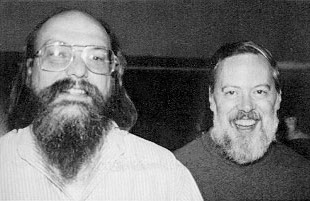
find ha origini altrettanto antiche: una sua prima versione compariva già nel primissimo Unix del 1971. Una successiva implementazione, sviluppata da Dick Haight, arrivò con Unix Version 5 nel 1974.

https://www.blogger.com/profile/12989641941024072869
Parliamo quindi di strumenti con oltre mezzo secolo di storia, nati quando i computer occupavano intere stanze.
Da allora, attraverso implementazioni ed evoluzioni successive, questi comandi sono diventati parte integrante del mondo Unix, arrivando fino a Linux, BSD e macOS.
E dopo più di 50 anni sono ancora lì, a fare egregiamente il loro lavoro.